近日,卓世科技AI研究院发布GR-SAC(Gated Residual Soft Actor-Critic)方法,并同步开放模型代码、参考权重和技术报告。该方法面向具身智能长时程操作中的执行偏差问题,在RoboMME Standard方向取得领先成绩。官方信息显示,它在冻结基座模型的基础上仅增加约0.0041%的推理参数,相对失败率下降5.32%。
RoboMME由密歇根大学、斯坦福大学及Figure AI研究人员共同提出,相关论文入选ICML 2026 Oral。与单次抓取或放置测试不同,该基准关注机器人在长时程操作中能否记住此前发生的事情、理解当前进展并转化为动作。基准围绕时间、空间、物体和过程记忆设置16项任务,标准评测共800次测试,每项任务50次。公开排行榜汇集了斯坦福大学、清华大学、华中科技大学、NVIDIA等机构团队的研究成果。
在任务设置上,RoboMME包含Counting、Permanence、Reference和Imitation等类型。以BinFill为例,机器人要统计已放入容器的方块数量,并在合适时机按下结束按钮;VideoUnmask要求记住物体被遮挡前的位置;VideoRepick需要从示范视频中认出此前被抓取过的同一方块;InsertPeg则要求理解示范中的夹取端和插入侧,并完成精细稳定的操作。这些任务同时考验任务理解、记忆保持和动作执行。
GR-SAC没有重新训练一个新的VLA模型,而是采用冻结原有VLA并叠加轻量化残差控制器的思路。研究选用开源模型SimpleMemVLA为基座,由基座继续理解历史画面、判断任务并生成机械臂动作序列;控制器在执行阶段观察前视与腕部摄像头画面、机械臂状态以及尚未执行的动作,对关节指令进行小幅修正。
从参数规模看,基座保持冻结,部署时只增加一个232,110参数的视觉残差控制器。它不重新理解整段任务,也不替代VLA生成的动作,而是在已有动作上做局部调整,从而保留基座模型原有的记忆与操作能力,并控制新增参数量。
在介入机制上,GR-SAC通过门控条件判断何时进行纠偏。控制器会观察当前规划动作是否相对平稳、机械臂是否接近目标关节位置、夹爪指令是否稳定;只有满足条件时才参与修正。当动作状态变化或夹爪需要切换时,门控关闭,避免不合时宜的干预。同时,方法对修正幅度设置边界,并引入衰减和重置机制,防止微小偏差在连续控制中累积。
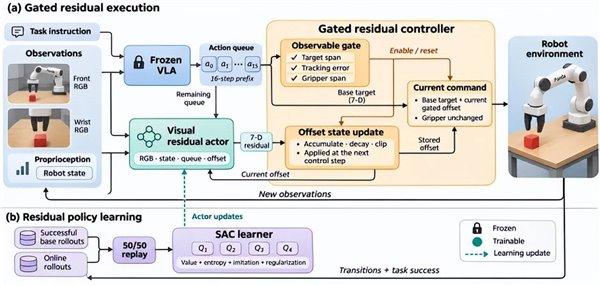
训练方面,GR-SAC使用Soft Actor-Critic强化学习算法。研究先让冻结的原模型在训练环境中执行任务,自动收集成功轨迹作为学习参考,再结合后续仿真交互中的成功与失败经验优化残差控制器,无需额外采集人工纠偏示范。
在RoboMME的16项任务、800次标准测试中,相比原始SimpleMemVLA,GR-SAC使相对失败率降低5.32%。其中,InsertPeg成功率由46%提升至52%,MoveCube由94%提升至100%,均提升6个百分点。团队还公开了逐任务结果和参考模型,便于社区复核与改进。
卓世科技此前已推出ZoeInside-VLA视觉语言动作模型,并在MolmoSpaces具身智能评测中取得成绩;公司还发布“启元”具身通用大脑,采用TriCore三核架构,由逻辑系统、直觉系统与共情系统分别承担任务规划、动作执行和人机交互等能力。围绕“璇玑玉衡”大模型体系以及具身智能数据采集、模型训练和大脑管理平台,公司持续开展从任务理解、动作生成到执行反馈的技术研发。
GR-SAC的代码、参考控制器权重、训练与评测脚本及实验结果已开放,供研究者使用、验证和交流。